

Créer un scénario, réparer un sélecteur, analyser une image ou préparer une évaluation de l'accessibilité : chaque tâche exige des capacités différentes de la part d'un modèle d'IA. Notre guide « benchmark » vise à aider les équipes à choisir des modèles en fonction de leur valeur pratique, de leur temps de réponse et de leur coût.
Le besoin : automatiser davantage tout en conservant la pertinence des tests
Les équipes de validation doivent couvrir davantage de parcours utilisateurs, suivre le rythme des modifications apportées aux applications et analyser les résultats dans des délais très courts. L'IA peut les aider à créer des tests, à réduire certaines tâches d'maintenance s et à effectuer des vérifications difficiles à exprimer par une simple comparaison de valeurs.
Mais il ne suffit pas de multiplier les tests. Un scénario doit vérifier la bonne « règles métier ». Une correction doit toujours cibler le bon élément. Une analyse doit distinguer un problème avéré d’une hypothèse. Et le coût de ces opérations doit rester compatible avec la fréquence d’exécution des campagnes de tests.
La question est donc la suivante : quelle IA doit prendre en charge quelle tâche, sur la base de quelles données et avec quel niveau de contrôle ? C'est pourquoi nous comparons les modèles dans le cadre de cas d'utilisation concrets d'Agilitest.
Deux utilisations distinctes : la préparation d'un test et l'appel de l'IA pendant l'exécution
Dans Agilitest, l'IA peut intervenir à deux étapes différentes. Comprendre cette distinction permet de mieux cerner les paramètres, l'utilisation et la nature des résultats.
Un test créé à l'aide de l'IA peut s'exécuter sans recourir à l'IA. Si son scénario repose sur des actions déterministes et qu'aucune fonctionnalité d'IA en temps d'exécution n'est activée, sa réexécution ne nécessite pas d'appeler le modèle qui a contribué à sa création.
En revanche, une vérification sémantique, une analyse d'image ou une opération d'auto-réparation fait appel à un modèle d'IA lorsque cette fonctionnalité est utilisée. Ces appels ont un coût, une durée et un résultat à évaluer. L'utilisation de l'IA pour résumer un rapport constitue un autre cas d'utilisation distinct : elle porte sur les résultats d'exécution.
L'IA contribue à la création du référentiel de tests ; les utilisateurs gardent le contrôle ; ATS exécute les actions définies. L'appel à l'IA pendant l'exécution relève d'un choix de configuration.
1. Configuration générale : choix de l'IA de l'assistant
Le premier écran permet de gérer l'assistance par IA au sein d'Agilitest. Il permet aux utilisateurs d'activer l'IA et de choisir le fournisseur et le modèle avec lesquels ils souhaitent travailler.
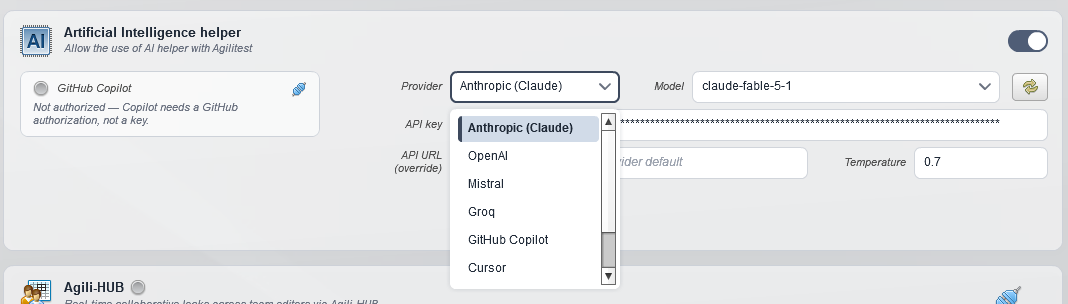
La liste affichée comprend Anthropic, OpenAI, Mistral, Groq, GitHub Copilot et Cursor, mais vous pouvez également vous connecter à un LLM interne tel qu’Ollama. La méthode de connexion dépend du fournisseur : par exemple, la capture d’écran indique que GitHub Copilot nécessite une autorisation GitHub plutôt qu’une clé API.
Les paramètres comprennent également une redéfinition de l'URL de l'API et une valeur de température. L'URL spécifie le point de terminaison lorsque l'intégration le prend en charge ; ce paramètre ne garantit pas à lui seul la compatibilité avec un service quelconque. La température fait partie des paramètres à enregistrer lors de la comparaison des résultats dans des conditions reproductibles.
L'assistant facilite la préparation et la compréhension des projets. Il peut aider à élaborer un scénario, à passer en revue les actions à mener ou à travailler sur le référentiel de tests maintenance. Le choix du modèle doit donc tenir compte de sa capacité à comprendre les instructions données sur Métier , de la qualité de ses suggestions, ainsi que de la rapidité de la conversation.
2. Configuration du projet : attribution de l'IA à chaque tâche
Dans les propriétés du projet, l'onglet « IA » permet de définir les fournisseurs disponibles lors de l'exécution des tests et pour les résumés de rapports. Cette configuration est distincte des paramètres de l'assistant.
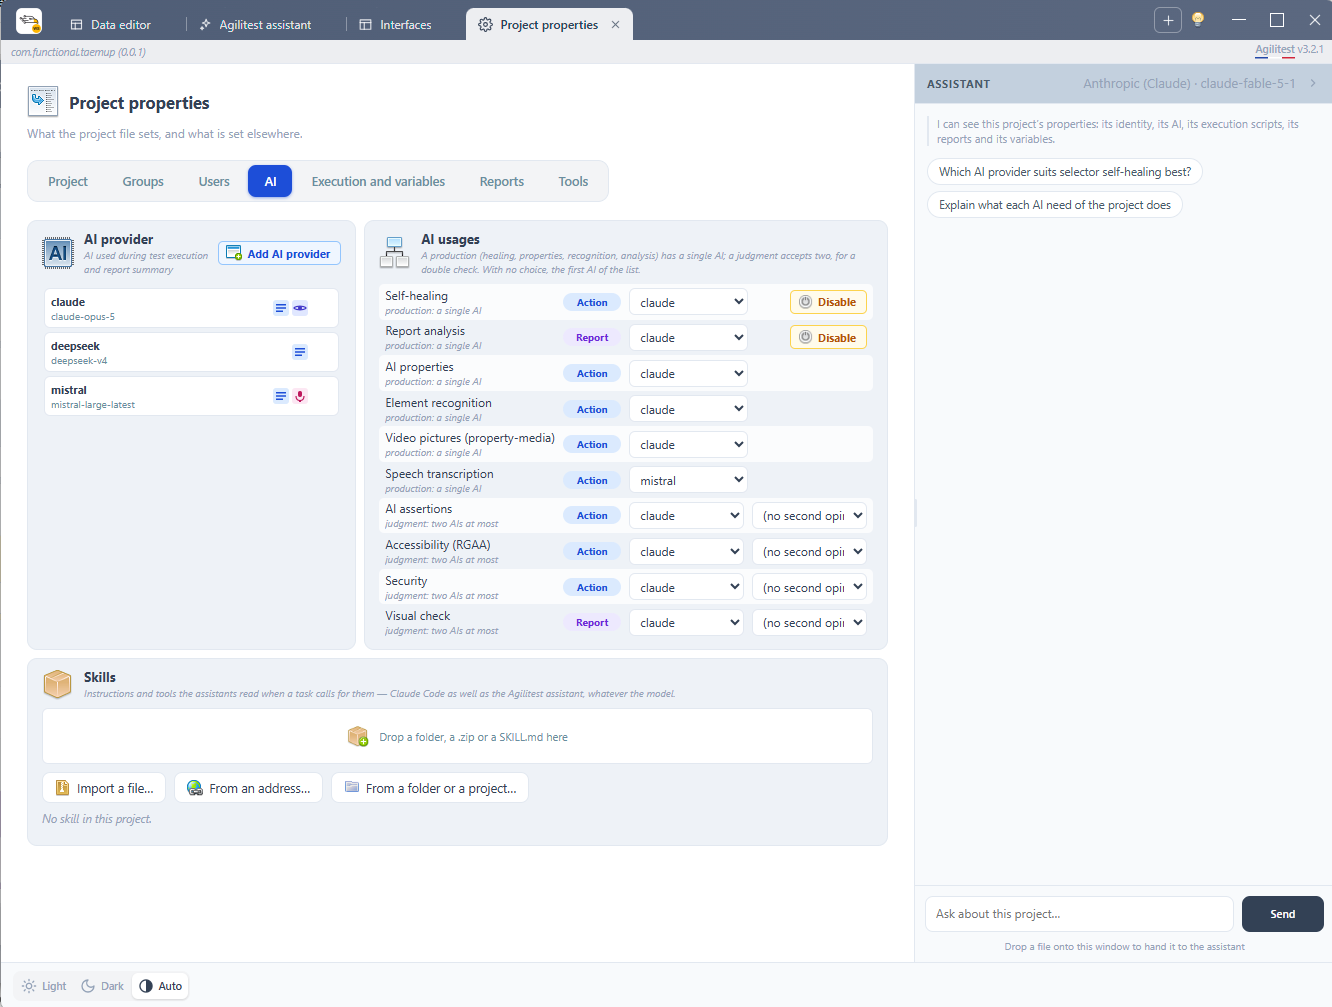
Un projet n'est pas obligé d'utiliser le même modèle pour chaque tâche. Il peut affecter un modèle d'IA à l'extraction de propriétés, un autre aux contrôles d'accessibilité et un autre encore à l'auto-réparation. Un modèle plus coûteux peut ainsi être réservé à une tâche pour laquelle sa qualité apporte un bénéfice tangible.
L'interface distingue deux catégories : les tâches de production, traitées par une seule IA, et les tâches d'évaluation, qui peuvent faire appel à deux IA au maximum pour un double contrôle. Un deuxième avis permet de vérifier s'il y a concordance ou divergence ; à lui seul, il ne garantit pas l'exactitude.
La capture d'écran précise également que, lorsqu'aucune attribution explicite n'est effectuée, c'est la première IA de la liste qui est utilisée. Le fait de vérifier ces attributions avant de lancer une campagne aide les équipes à maîtriser le fonctionnement du projet et son budget.
Utilisations configurables
Ces paramètres décrivent les options de configuration disponibles. Cela ne signifie pas pour autant que toutes les fonctionnalités soient présentes dans toutes les éditions d'benchmark , ni que tous les modèles prennent en charge tous les types de supports.
Compétences : fournir des consignes utiles pour la réalisation d'un projet
La section « Compétences » permet aux utilisateurs d’importer, à partir d’un fichier, d’une adresse ou d’un dossier, des instructions et des outils que les assistants peuvent utiliser le cas échéant. Elle fournit le contexte du projet et les méthodes de travail. Ce contexte joue également un rôle important dans une comparaison : un modèle guidé par des instructions détaillées ne fonctionne pas dans les mêmes conditions qu’un modèle qui n’en bénéficie pas.
3. Vérifications par l'IA : exprimer ce qui doit être vrai
L'action « Vérification IA » permet aux utilisateurs d'exprimer une condition en langage naturel. Sur la capture d'écran, elle cible la racine de l'application et demande aux utilisateurs de décrire « ce qui doit être vrai sur l'ensemble de la page ». Elle propose également différents types de cibles : élément d'interface, élément de paramètre, interface système ou boîte de dialogue.
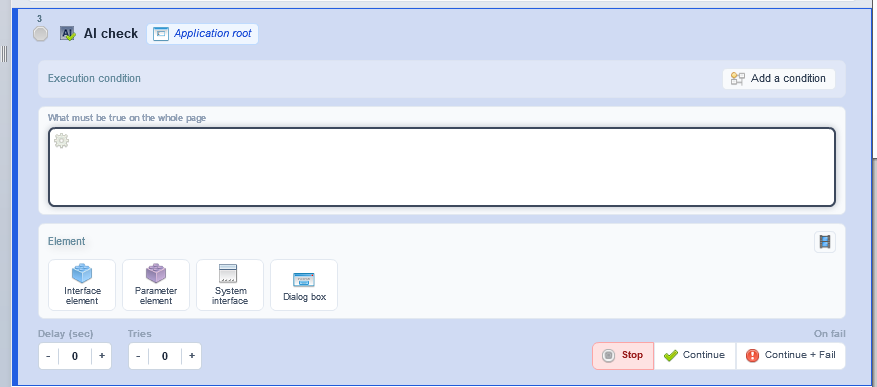
Par exemple, un contrôle pourrait vérifier si un message de confirmation explique clairement l'étape suivante d'un processus, ou si un récapitulatif de commande est cohérent. Ces exemples illustrent des instructions possibles ; leur fiabilité doit être évaluée à l'aide des données et des modèles sélectionnés.
Pour une valeur connue, telle qu'un montant attendu ou un identifiant, une assertion déterministe reste essentielle. Le jugement de l'IA prend tout son sens lorsqu'il s'agit de vérifier le sens, la pertinence ou le contenu, dont la forme peut varier.
Documents, images, vidéos et fichiers audio : choisir le format d'importation adapté
Les utilisations peuvent porter sur le document de l'application, un élément ciblé ou un contenu multimédia fourni à l'action correspondante. Ce qui peut être observé dépend des données fournies et des capacités du modèle. Une IA qui reçoit un extrait ne peut pas se prononcer sur un contenu qu'elle n'a pas reçu.
Les propriétés d'IA génèrent des informations réutilisables ; les assertions évaluent une condition ; les fonctionnalités liées aux médias et à la transcription traitent leurs types d'entrée respectifs. Il convient de distinguer ces rôles lors de la rédaction d'un scénario.
L'benchmark e doit évaluer sa capacité à répondre correctement et à éviter d'avancer des informations manquantes ou incertaines. Une réponse convaincante peut tout de même être erronée.
4. Auto-réparation : réparer la reconnaissance sans affaiblir le contrôle
Une modification de l'interface peut rendre un sélecteur obsolète, même si la fonction « Métier » reste disponible. La fonctionnalité d'auto-réparation peut alors faire appel au modèle configuré pour trouver une cible de remplacement.
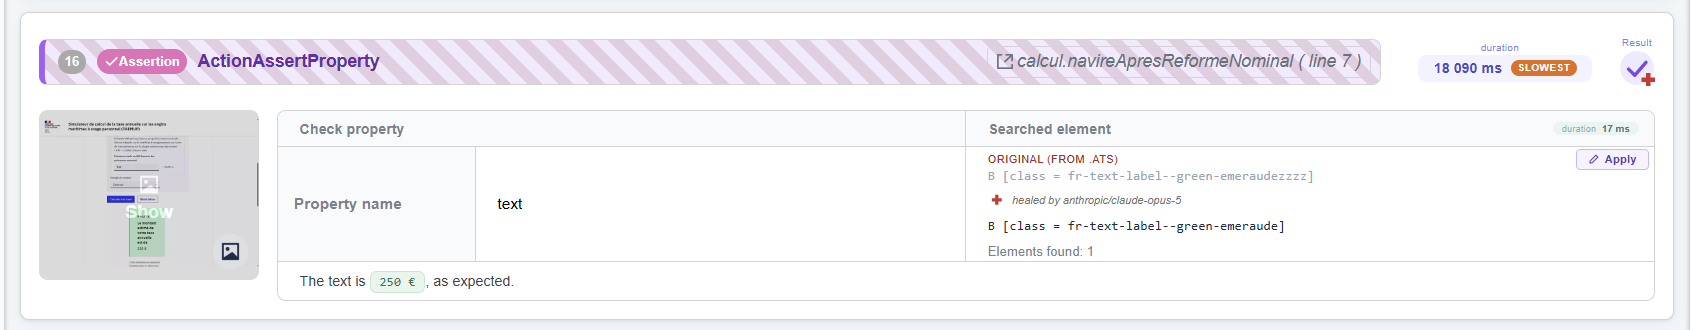
Dans l'exemple fourni, le sélecteur d'origine contient une classe se terminant par emeraudezzzz. La correction identifie la classe se terminant par émeraude. Le rapport indique qu'un élément a été retrouvé et que son texte est le suivant : €250, comme prévu.
La correction de la cible et la validation du résultat de l'Métier ion restent deux opérations distinctes. Il ne suffit pas de trouver un élément : le test doit encore vérifier que cet élément affiche le résultat attendu.
Le bouton « Appliquer » permet d'intégrer la correction proposée dans le référentiel de tests. Le rapport d'exécution fourni indique également que la fonction d'auto-correction est activée, avec un budget affiché de 1 par test. Cela permet de visualiser les limites de fonctionnement de cette fonctionnalité.
Lorsqu'elles comparent des modèles, les équipes doivent évaluer leur capacité à corriger les erreurs de reconnaissance réelles, à éviter les cibles erronées et à laisser un test échouer lorsque le résultat de l'Métier ation est incorrect. Se contenter de compter le nombre de tests qui passent au vert ne suffit pas.
5. Accessibilité : allier contrôles automatisés, avis générés par l'IA et validation humaine
Le rapport RGAA fourni montre pourquoi les conclusions issues de l'IA doivent être accompagnées de leur provenance. Le RGAA est le référentiel français d'évaluation de l'accessibilité. Ce rapport rassemble les résultats automatisés, les évaluations de l'IA, les non-conformités présumées et les vérifications nécessitant une intervention humaine.
Les exemples sont concrets : vérifier si une description alternative existe relève d'un contrôle structurel ; évaluer si celle-ci décrit correctement une image nécessite de tenir compte du contexte. Le rapport comprend des analyses portant sur un titre vide, la pertinence des descriptions alternatives des images et les animations dépourvues de mécanisme d'arrêt visible.
Pour chaque point, les lecteurs trouveront la question posée, les éléments vérifiés par « ATS », les éléments concernés, le résultat ou le raisonnement de l'IA, ainsi que les raisons pour lesquelles une conclusion peut encore rester en suspens.
Un statut équivalent à « conforme selon une IA » reste considéré comme une évaluation préliminaire nécessitant un examen. Une suspicion est présentée comme un élément à confirmer. Certaines vérifications, telles que la manière dont un élément est réellement lu par un lecteur d'écran, nécessitent une validation humaine.
Ce rapport propose un audit guidé permettant de réexaminer les parcours utilisateurs et d'indiquer si ceux-ci sont « conformes », « non conformes » ou « sans objet ». Cela permet d'organiser le travail de validation plutôt que de masquer les questions en suspens derrière une note.
Le score automatisé affiché ne doit pas être présenté comme le taux de conformité global du site web. Le rapport distingue ce score des critères pour lesquels des conclusions, un niveau de confiance et une couverture de l'échantillon ont été établis. Ces indicateurs répondent à des questions différentes.
6. Sécurité et analyse des rapports : garantir la vérifiabilité des conclusions
La configuration du projet prévoit également le recours à l'IA à des fins de sécurité. Le scénario décrit dans le rapport se déroule comme suit : vérification de sécurité [IA] et check-wcag [ia], ainsi que des propriétés IA et un sélecteur d'éléments délibérément incorrect.
La désignation d'une action de sécurité ne suffit pas à elle seule à décrire toutes les vulnérabilités faisant l'objet d'une enquête. Pour interpréter ses résultats, il faut savoir quels contrôles ont été effectués et quelles preuves ont été recueillies. Une conclusion doit pouvoir être vérifiée par rapport au comportement observé.
L'analyse des rapports d'IA aide les utilisateurs à interpréter les résultats. Le critère de qualité réside dans la fidélité avec laquelle le résumé les restitue : distingue-t-il une erreur fonctionnelle, un problème de reconnaissance, une réparation et une analyse qui reste incertaine ? Un résumé utile facilite l'investigation et permet aux lecteurs de revenir aux éléments probants du rapport sous-jacent.
Pourquoi publier une « benchmark » par cas d'utilisation ?
Ces fonctionnalités nécessitent des capacités différentes. Extraire une propriété simple, analyser un contenu visuel et proposer un sélecteur de remplacement ne requièrent pas automatiquement le même modèle.
Notre « benchmark » vise à réunir trois dimensions :
- Pertinence : précision des résultats, respect des instructions, erreurs, omissions et nécessité d'une correction humaine.
- Durée : la latence des appels et son impact sur la campagne.
- Coût : consommation de jetons et frais d'appel en fonction du volume d'utilisation réel.
Le coût par appel ne reflète pas le coût total d'une activité. Les nouvelles tentatives, les réponses inutilisables et le temps consacré à l'analyse jouent également un rôle. Il s'agit là de critères à consigner ; ils ne sont pas tous pris en compte dans chaque exportation d'benchmark .
Pour qu'une comparaison soit utile, il faut disposer d'instructions, de données et de paramètres comparables, ainsi que d'un nombre suffisant d'observations. Une durée manquante reste une mesure indisponible. Une évaluation humaine doit être justifiée. Les économies calculées à partir d'un tarif de référence ne prouvent pas qu'un autre modèle aurait donné un résultat tout aussi satisfaisant.
Benchmark Ces éditions doivent donc être considérées comme des observations ponctuelles des cas d'utilisation qu'elles traitent. Elles aident les équipes à faire des choix et à planifier des essais en fonction de leurs propres scénarios ; elles ne désignent pas de solution universelle.
Choix délibérés en matière d'IA, tests contrôlés
L'objectif est de déterminer dans quels domaines l'IA apporte une valeur ajoutée. L'assistant peut accélérer la préparation du référentiel de tests. Les fonctionnalités liées au temps d'exécution peuvent enrichir certaines vérifications ou faciliter l'maintenance. Dans les deux cas, l'équipe doit être en mesure de comprendre ce qui s'est passé et quelles preuves étayent le résultat.
En dissociant la configuration des assistants des affectations d'IA au niveau des projets, Agilitest permet aux équipes d'adapter leurs choix à chaque tâche. L'benchmark e fournit des éléments permettant d'évaluer et d'affiner ces choix, tout en plaçant les exigences métier et la validation humaine au cœur du processus.


