

Action de propriété
Qu'est-ce que l'action immobilière ?
L'action « Property » sert à récupérer la valeur d'un attribut ou d'une propriété d'un élément graphique capturé et à l'enregistrer dans une variable. Contrairement à une validation (assertion), cette action n'interrompt pas le test si la valeur n'est pas celle attendue ; son seul objectif est de « lire » l'information.
Dans votre script, sélectionnez l'action « Propriété » dans le menu Actions.
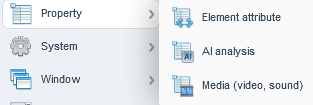
Attribut d'élément
Cette fonctionnalité permet d'extraire une caractéristique spécifique d'un élément d'interface (que ce soit sur le Web, dans une application de bureau ou dans une application mobile). Elle analyse le code sous-jacent (tel que le DOM en HTML ou l'arborescence des composants en code natif) et récupère la valeur exacte d'un attribut ciblé.
Lorsque vous ajoutez une action « Propriété » à un élément capturé, vous devez configurer deux éléments principaux :
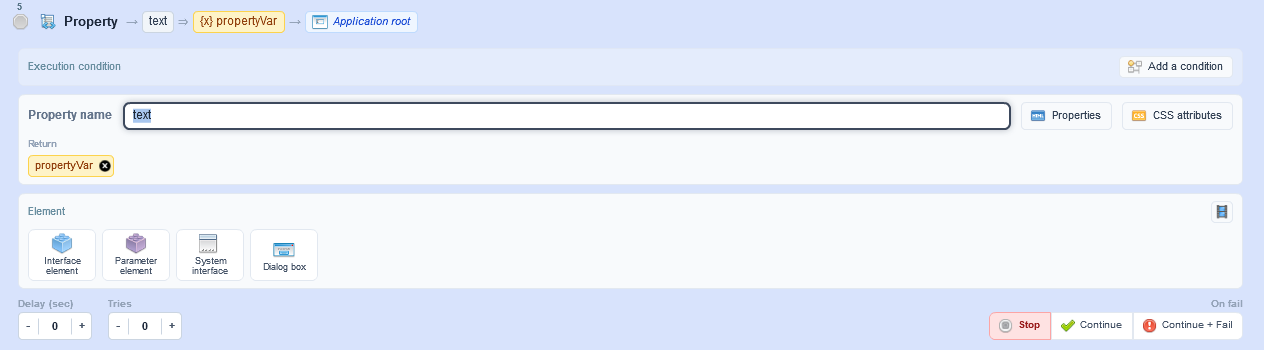
- Nom du bien immobilier : L'attribut spécifique que vous souhaitez lire.
- Web : id, class, href, src, value, placeholder, etc.
- Propriétés calculées : Agilitest vous permet également de récupérer des propriétés telles que « text » (texte visible) ou « checked » (pour les cases à cocher).
- Élément : élément d'interface, élément de paramètre, interface système, boîte de dialogue
Analyse par IA
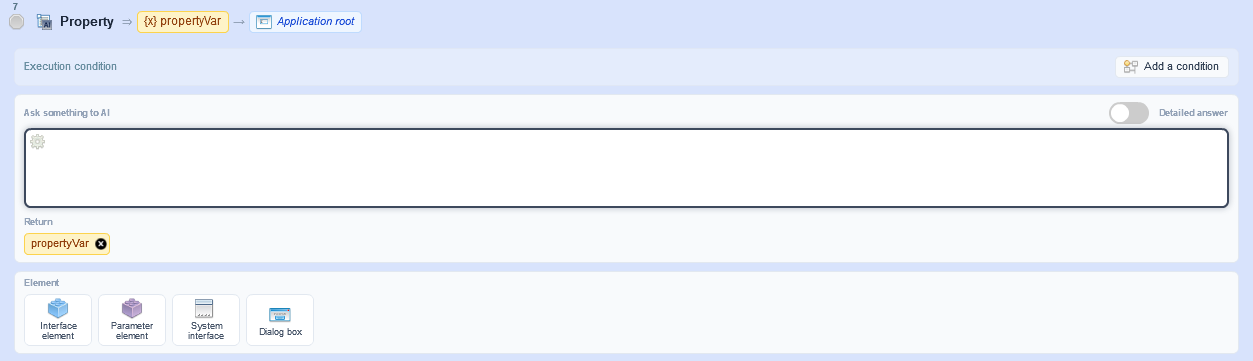
Il s'agit d'une fonctionnalité moderne intégrée à ATS afin de pallier les limites de la recherche technique traditionnelle. Elle utilise un modèle d'IA (via les fournisseurs d'IA que vous pouvez configurer dans votre projet, tels que les modèles OpenAI ou Claude d'Anthropic).
Au lieu de récupérer une propriété technique préexistante, le script transmet l'élément ciblé (généralement via une capture d'écran de cet élément) à une IA, accompagné d'une consigne (une question ou une instruction). L'IA analyse l'image ou le contexte et renvoie sa réponse sous forme de texte qui sera stocké dans votre variable.
Au lieu de récupérer une caractéristique technique préexistante, le script envoie l'élément ciblé (généralement via une capture d'écran de cet élément) à une IA, accompagné d'une consigne (une question ou une instruction).
L'IA analyse l'image ou le contexte et renvoie sa réponse sous forme de texte, qui sera stockée dans votre variable.
Exemples :
Lire du texte manuscrit dans un document PDF numérisé (OCR avancé), vérifier le contenu d'un composant très complexe (tel qu'un Canvas HTML5 dont les éléments n'existent pas dans le DOM), ou valider qu'une image correspond sémantiquement au produit attendu.
L'action « immobilier-médias »
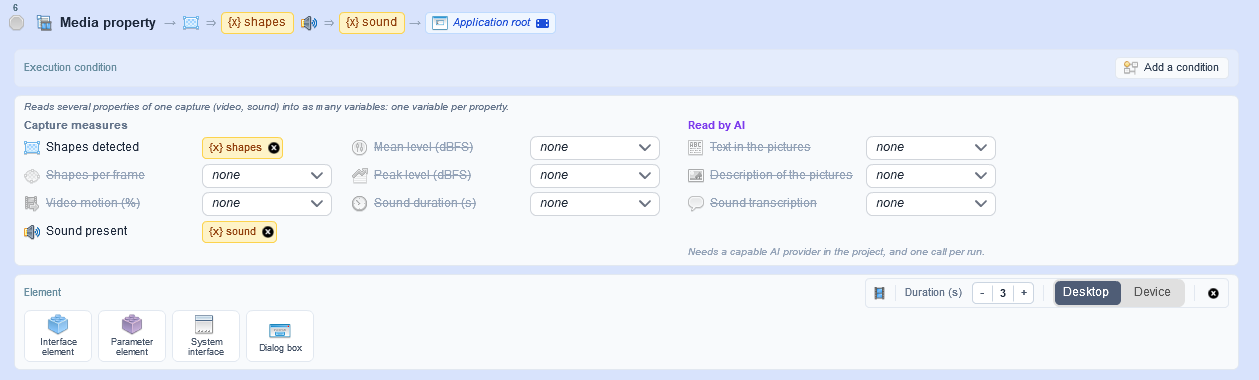
Ces propriétés se répartissent en deux catégories :
- Mesures de capture (formes, mouvement, son)
- Lu par une IA
Chaque propriété est associée à la variable qui reçoit sa valeur. Vous pouvez faire glisser une variable depuis le panneau des variables vers une propriété, ou la déplacer d'une propriété à une autre.
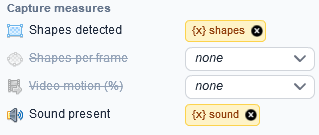
Une fois l'exécution terminée, le résultat s'affiche propriété par propriété, avec indication du modèle d'IA utilisé, et une erreur apparaît sur la ligne de la propriété concernée.
La méthode `property-media` lit plusieurs propriétés d'un enregistrement en une seule opération et attribue chacune d'elles à une variable.
Exemple :
« property-media -> shapes-count,audio-has-sound,audio-rms-db => count,sound,level -> @RECORD […] ».
Toutes les valeurs proviennent du même enregistrement, et non d'une capture distincte pour chaque propriété vérifiée.
L'éditeur reçoit la valeur de chaque variable séparément.
Le « video-motion » mesure, sans recourir à l'IA, la proportion d'images qui changent d'une image à l'autre.
Si l'outil de capture ne peut pas fournir une propriété, l'action échoue au lieu de laisser une variable vide. Une ligne mal écrite échoue immédiatement, avant la capture, avec une indication sur ce qu'il faut corriger.
Dans le rapport, chaque action dispose de sa propre fiche : jauge de mouvement, niveaux sonores, icône « son » ou « silence », variable associée à chaque valeur, élément filmé et vidéo capturée.
Lecture par l'IA
L'action « property-media » peut comporter une vidéo analysée par l'IA :
- La fonction « Vidéo-texte » renvoie le texte qui s'affiche à l'écran (inscriptions, titres, sous-titres), sans doublons.
- La description vidéo décrit ce que montrent les images (personnes, objets, lieux, éclairage)
- La fonction « Audio-text » transcrit ce qui est dit et renvoie une valeur vide pour une vidéo sans son, sans faire appel à l'IA.
L'analyse utilise les images clés et le son d'un seul enregistrement, aussi bien sous Windows que sous Linux. Sur une page Web, le texte affiché par la page par-dessus la vidéo (menus, synopsis, commandes du lecteur) est ignoré.
Deux utilisations de l'IA sont définies dans le projet : « médias » pour les images et « audio » pour la transcription. La description est rédigée dans la langue configurée pour l'IA, et la transcription détecte automatiquement la langue parlée.
Les résultats tiennent sur une seule ligne, prêts à être vérifiés à l'aide d'une valeur de contrôle, et le rapport indique l'IA et le modèle utilisés pour chaque lecture. Si aucune IA configurée ne permet d'effectuer la lecture demandée, ou si l'driver e du système est trop ancienne, l'opération échoue avant la capture et le motif de l'échec est expliqué.


